Sisukord
Järeldamine tähendab seda, kui kasutatakse tehisintellekti mudelit
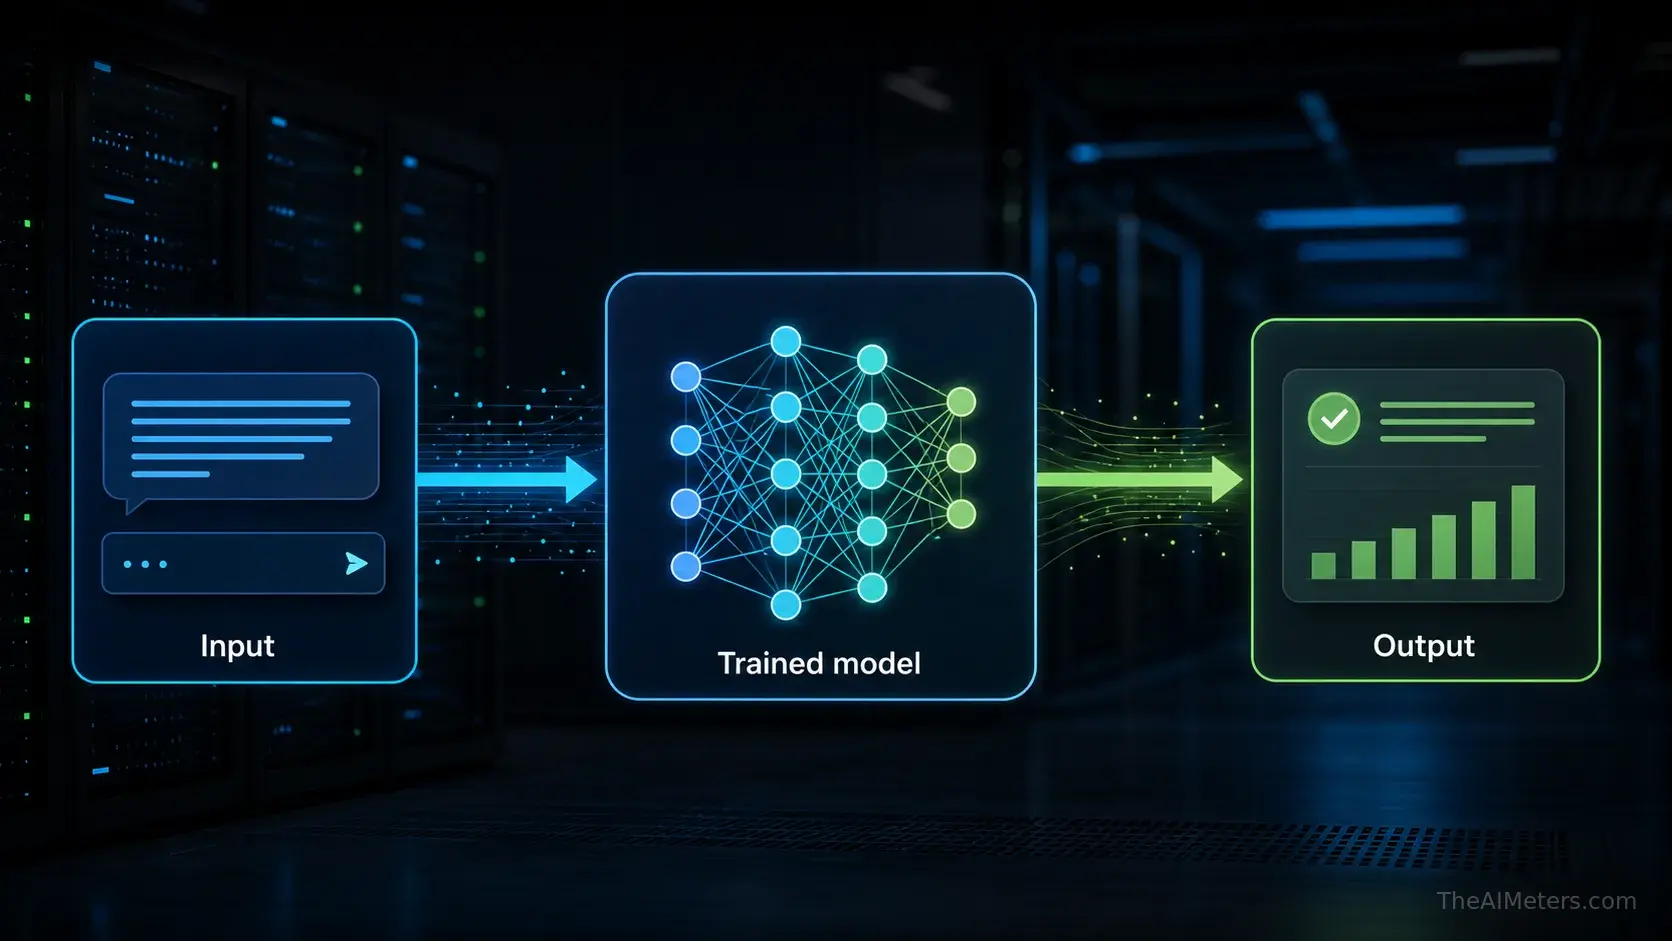
Tehisintellekti järeldamine toimub pärast seda, kui mudel on juba treenitud. Kasutaja, rakendus või automatiseeritud süsteem saadab uue sisendi ning treenitud mudel kasutab treeningu käigus omandatud teadmisi, et genereerida kasulik väljund.
Sisendiks võib olla kirjalik ülesanne, otsingupäring, toote pilt, helisalvestis, koodirida või andmebaasi rida. Väljundiks võib olla vastus, genereeritud pilt, klassifikatsioon, soovitus, tõlge või ennustus.
Seetõttu hõlmab iga ChatGPT vastus, tehisintellekti abil loodud pilt, otsingumootori tulemus, soovitussüsteemi soovitus ja sisu modereerimise otsus järelduste tegemist. Mudelit ei ehitata iga kord uuesti üles, vaid seda rakendatakse uute andmete põhjal.
Koolitus loob mudeli, järeldamine käivitab selle
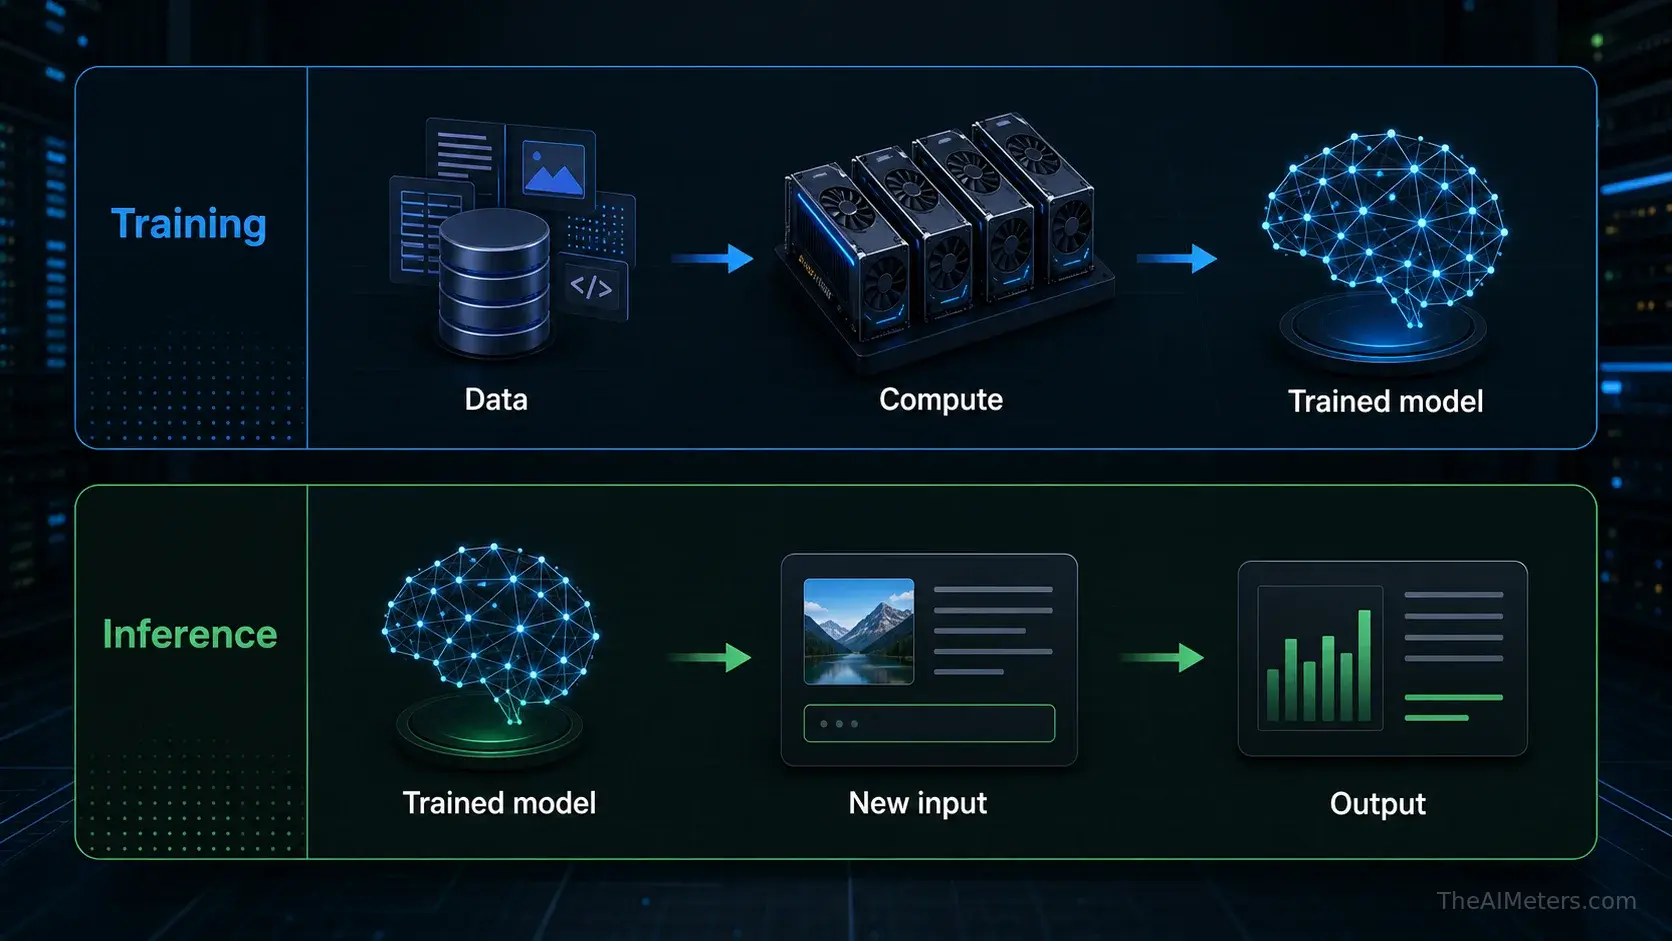
Õppimine ja järeldamine on sama tehisintellekti süsteemi kaks erinevat etappi. Õppimise käigus luuakse või uuendatakse mudelit, töödeldes suuri andmekogumeid, võrreldes ennustusi näidetega ja kohandades sisemisi parameetreid paljude korduvate sammude jooksul.
Järeldamine algab alles siis, kui koolituse tulemusena on saadud kasutatav mudel. Koolitatud mudel võetakse kasutusele serverites, võtab vastu uusi sisendandmeid ja rakendab õpitud mustreid, ilma et oleks vaja uuesti läbida kogu koolitusprotsessi.
Erinevust on lihtne meeles pidada järgmiselt: treenimine on see, kuidas mudel õpib, järeldamine aga see, kuidas mudelit kasutatakse. Esimese etapi põhjalikuma selgituse leiate juhendist, milles kirjeldatakse, kuidas tehisintellekti mudeleid treenitakse.
Mis toimub tehisintellekti järeldamise käigus?
Täpsed sammud sõltuvad mudeli tüübist, kuid põhiline protsess on sarnane. Sisend jõuab süsteemi, süsteem vormistab selle mudeli jaoks sobivasse vormingusse, mudel teostab arvutused oma parameetrite põhjal ning süsteem muudab mudeli väljundi vormingusse, mida kasutaja saab lugeda, vaadata või kasutada.
Keelemudeli puhul jagatakse sisend tavaliselt märkideks. Mudel analüüsib neid märke ja ennustab tõenäolisi järgmisi märke samm-sammult. Pildimudeli puhul võib sisendiks olla tekst, pilt või mõlemad, ning mudel genereerib järk-järgult piksleid või visuaalseid tunnuseid, mis vastavad päringule.
Muud süsteemid võivad dokumente klassifitseerida, otsingutulemusi järjestada, pildil olevaid objekte tuvastada, kõnet transkribeerida või tooteid soovitada. Igal juhul on järeldamine see reaalajas toimuv samm, mis muudab uue sisendi mudeli väljundiks.
Miks järelduste tegemiseks on vaja arvutusvõimsust
Tehisintellekti järeldamine ei ole lihtsalt andmebaasist otsimine. Suur mudel võib sisaldada miljardeid parameetreid ning selle kasutamine nõuab palju matemaatilisi operatsioone, et edastada teavet mudeli kaudu ja arvutada järgmine väljund.
See arvutus peab sageli toimuma kiiresti. Chatboti vastus, otsingumootori vastus või reaalajas tõlge peaksid jõudma kohale sekundite jooksul või isegi kiiremini, mistõttu on järeldussüsteemide puhul olulised viivitus, mälu ribalaius, andmete kogumine partiidesse, mudeli suurus ja riistvara kasutamine.
Graafikaprotsessorid (GPU) ja muud tehisintellekti kiirendid on kasulikud, kuna suudavad tõhusalt teostada paljusid paralleelseid operatsioone. Mida suurem on mudel, mida pikem on kontekst ja mida rohkem on samaaegseid kasutajaid, seda hoolikamalt tuleb järeldusinfrastruktuuri kavandada.
Näited järelduste tegemisest igapäevases tehisintellektis
Kui chatbot vastab küsimusele, teeb ta järeldusi. Sama kehtib ka siis, kui pildigeneraator loob pildi sisendteksti põhjal, programmeerimisabi soovitab funktsiooni või tõlketööriist teisendab lause teise keelde.
Järeldamine esineb ka vähem silmatorkavates süsteemides. Soovituste voog, mis järjestab videoid; pettuste tuvastamise süsteem, mis märgistab tehingu; meditsiinilise pildistamise mudel, mis tõstab esile uuritava piirkonna; või tehase pilditöötlussüsteem, mis tuvastab defekte – need kõik kasutavad uute andmete puhul treenitud mudeleid.
Need näited näevad kasutajate jaoks erinevad välja, kuid neil on sama põhimudel: treenitud mudel võtab vastu sisendi, teostab arvutusi ja annab väljundi, mis toetab otsust, vastust või genereeritud tulemust.
Miks järeldamine on oluline energia- ja infrastruktuurivaldkonnas
Üks järelduspäring võib olla väike, kuid tänapäevased tehisintellekti süsteemid töötavad tohutul skaalal. Miljonid või miljardid sisestusülesanded, pildipäringud, soovitused ja API-kõned võivad tekitada pidevat koormust graafikaprotsessoritele, võrgustikele, salvestusseadmetele ja jahutussüsteemidele.
Seetõttu on järeldamine tehisintellekti infrastruktuuri keskmes. Kuigi mudeli treenimine võib olla kõige silmatorkavam arvutusprotsess, toimub järeldamine iga kord, kui inimesed kasutavad kasutusele võetud tehisintellekti tööriistu. Globaalsel tasandil võib see korduv kasutamine muutuda GPU-de nõudluse ja andmekeskuste elektritarbimise peamiseks mõjutajaks.
Ühe tehisintellekti päringu täpne energiakulu sõltub mudeli suurusest, riistvarast, partiide koondamisest, kasutusastmest, andmekeskuse tõhususest ja väljundi tüübist. Oluline on see, et järeldamine seob igapäevase tehisintellekti kasutamise füüsilise infrastruktuuriga: kiibid, serverid, elektrienergia, jahutus ja andmekeskused.
Kuidas järeldamist optimeeritakse
Tehisintellekti pakkujad panustavad palju inseneritööd, et muuta järelduste tegemine kiiremaks, odavamaks ja tõhusamaks. Paki töötlemise abil saab mitut päringut korraga töödelda, vahemällu salvestamise abil saab korduvat tööd uuesti kasutada ning suunamise abil saab lihtsamad ülesanded suunata väiksematele või spetsialiseeritud mudelitele.
Muud meetodid vähendavad vajaliku arvutusmahtu. Kvantiseerimine võimaldab mudeli väärtusi esitada kompaktsemalt, destillatsioon võimaldab käitumist üle kanda väiksemasse mudelisse ning okste eemaldamine või arhitektuuri muutmine võimaldab eemaldada tarbetut tööd, säilitades samal ajal kasuliku kvaliteedi.
Oluline on ka spetsiaalne riistvara. Graafikaprotsessorid, tehisintellekti kiirendid, kiired võrguühendused ja suure läbilaskevõimega mälu aitavad kasutusele võetud mudelitel töötada usaldusväärselt ka suurel skaalal. Järelduste tegemise suurem tõhusus võib vähendada viivitust, kulusid ja elektritarbimist, kuid see ei tee infrastruktuuri kaduma.