Saturs
Inference notiek tad, kad tiek izmantots mākslīgā intelekta modelis
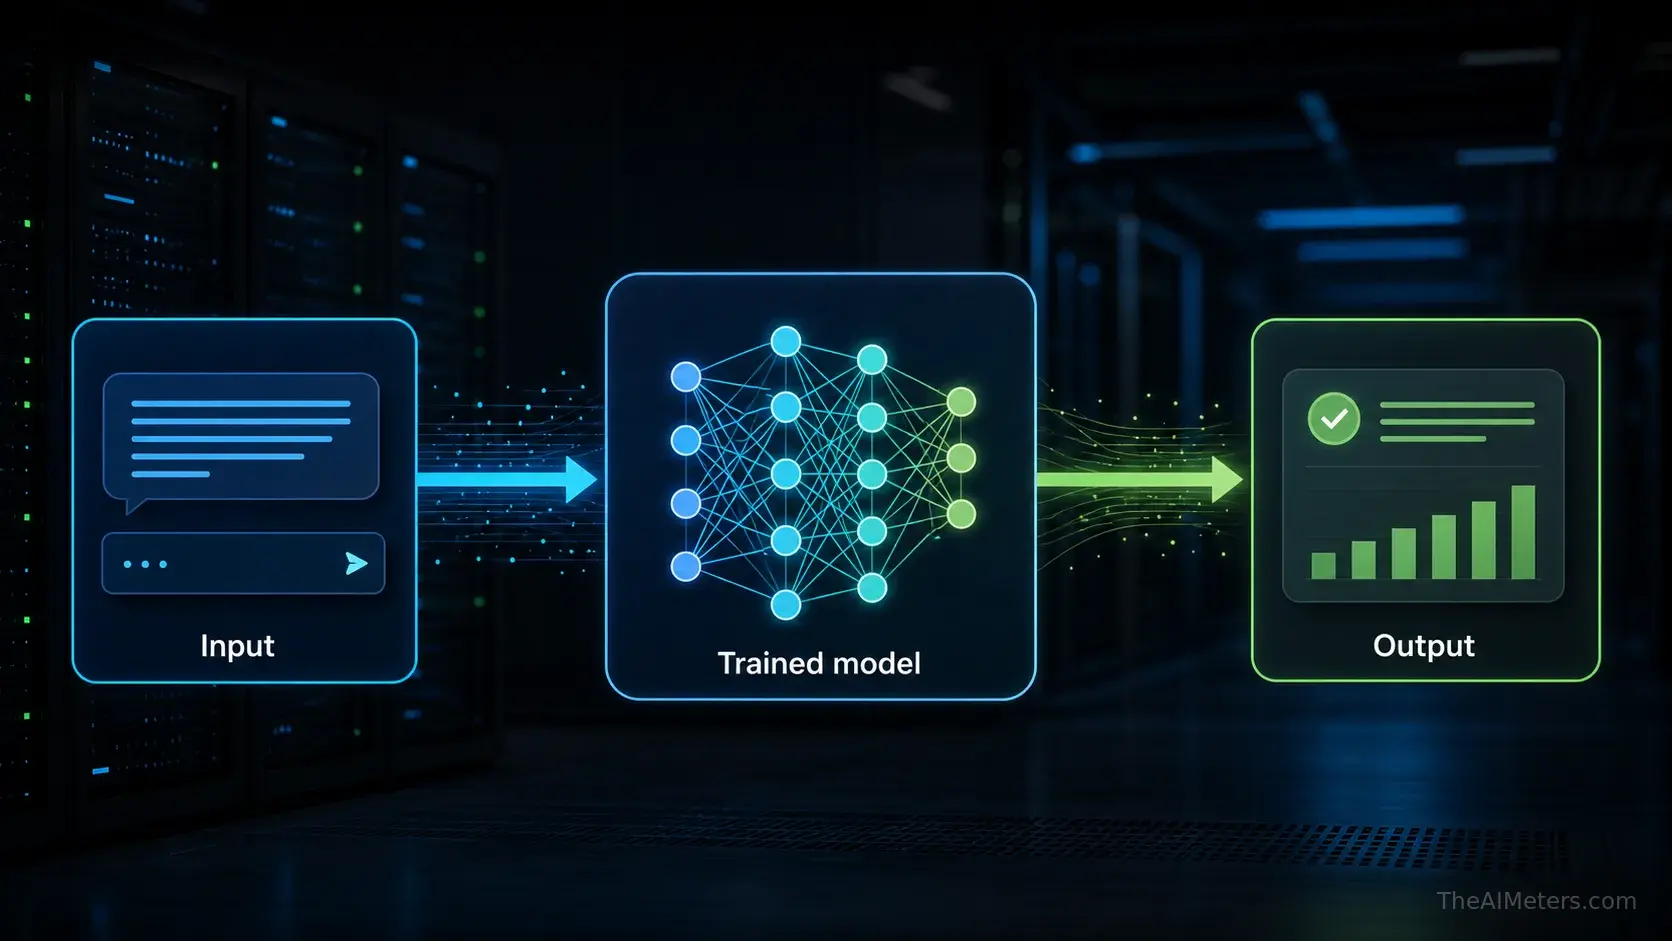
Mākslīgā intelekta inference notiek pēc tam, kad modelis jau ir apmācīts. Lietotājs, lietojumprogramma vai automatizēta sistēma nosūta jaunu ievadi, un apmācītais modelis izmanto apmācības laikā apgūto, lai ģenerētu noderīgu izvadi.
Šī ievade var būt rakstisks uzdevums, meklēšanas vaicājums, produkta attēls, balss ieraksts, koda rinda vai datu bāzes rinda. Rezultāts var būt atbilde, ģenerēts attēls, klasifikācija, ieteikums, tulkojums vai prognoze.
Tāpēc katrā ChatGPT atbildē, mākslīgā intelekta radītā attēlā, meklēšanas palīga rezultātā, ieteikumu sistēmā un satura moderēšanas lēmumā tiek izmantota secināšana. Modelis netiek pārveidots katru reizi no jauna. Tas tiek piemērots jauniem datiem.
Apmācība izveido modeli, inference to darbina
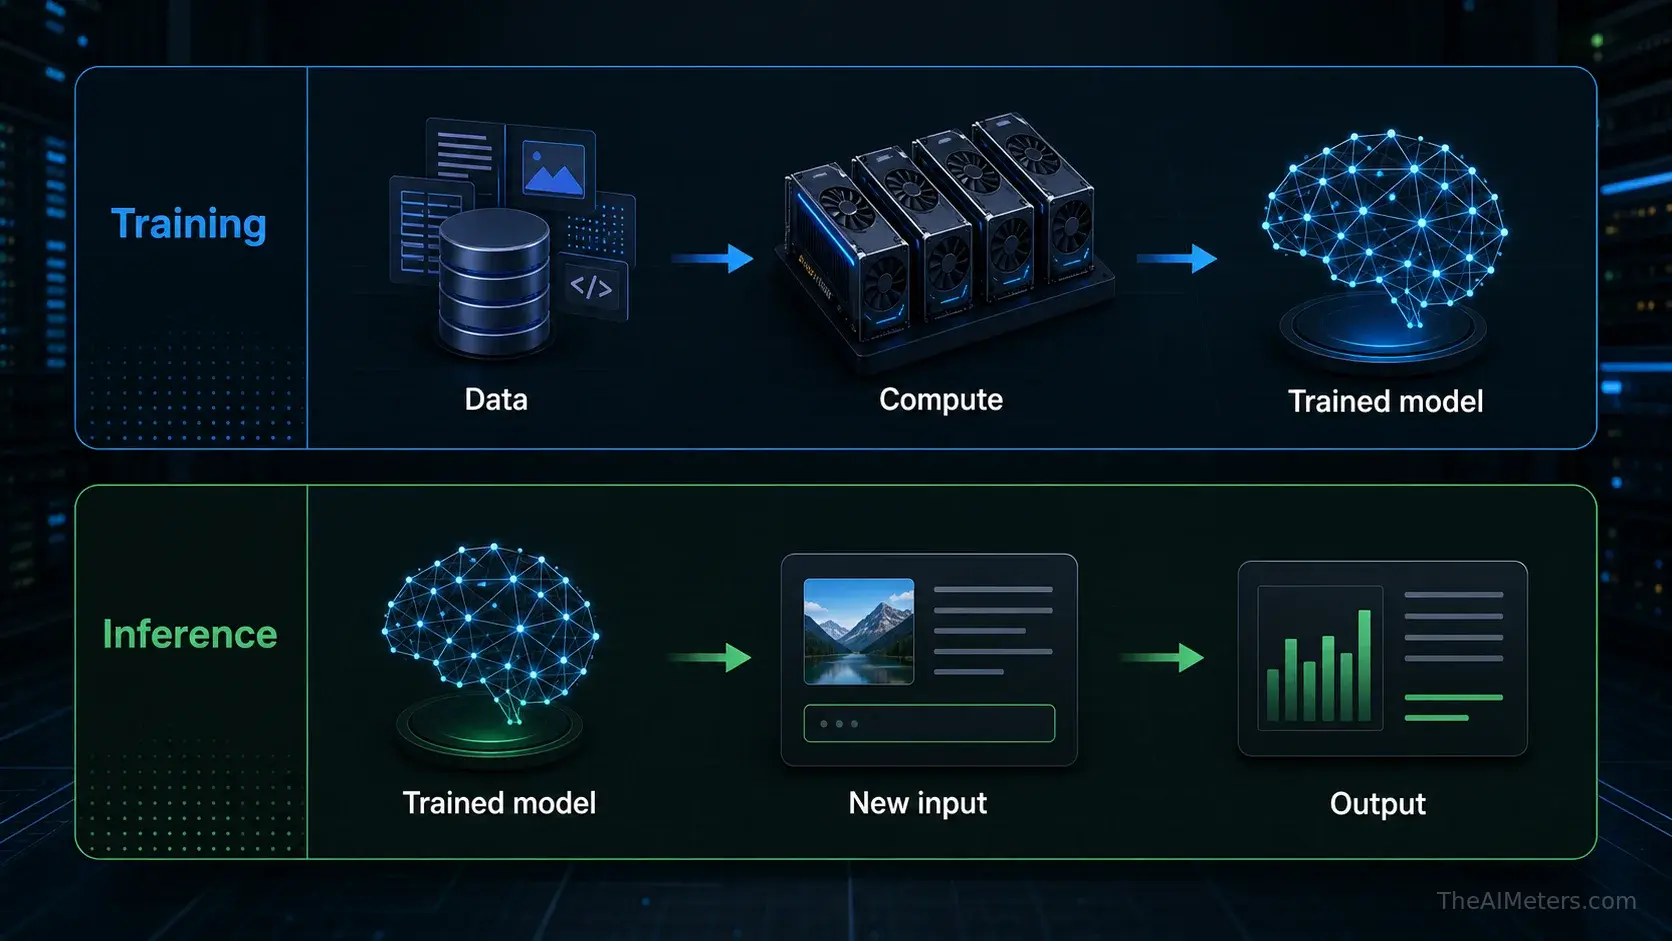
Mācīšana un secināšana ir divi atšķirīgi vienas un tās pašas mākslīgā intelekta sistēmas posmi. Mācīšanas procesā tiek izveidots vai atjaunināts modelis, apstrādājot lielus datu kopumus, salīdzinot prognozes ar piemēriem un pielāgojot iekšējos parametrus daudzos atkārtotos posmos.
Secināšana sākas pēc tam, kad apmācības procesa rezultātā ir izveidots lietojams modelis. Apmācītais modelis tiek ieviests serveros, saņem jaunus ievaddatus un piemēro apgūtos modeļus, neizietot pilnu apmācības procesu no jauna.
Vienkāršs veids, kā atcerēties atšķirību, ir šāds: apmācība ir process, kā modelis mācās, savukārt secināšana ir veids, kā modelis tiek izmantots. Lai iegūtu sīkāku izklāstījumu par pirmo posmu, skatiet rokasgrāmatu par to, kā tiek apmācīti AI modeļi.
Kas notiek AI inference laikā?
Konkrētie soļi ir atkarīgi no modeļa veida, taču vispārējā darbības gaita ir līdzīga. Tiek saņemti ieejas dati, sistēma tos sagatavo formātā, kādu paredz modelis, modelis veic aprēķinus, izmantojot savus parametrus, un sistēma pārveido modeļa izvadi tādā formā, ko lietotājs var izlasīt, apskatīt vai izmantot.
Valodas modelim ievades frāze parasti tiek sadalīta simbolos. Modelis izvērtē šos simbolus un soli pa solim prognozē iespējamos nākamos simbolus. Attēla modelim ievade var būt teksts, attēls vai abi, un modelis pakāpeniski ģenerē pikseļus vai vizuālas pazīmes, kas atbilst pieprasījumam.
Citas sistēmas var klasificēt dokumentu, rangēt meklēšanas rezultātus, atpazīt objektus attēlā, transkribēt runu vai ieteikt produktu. Katrā gadījumā secināšana ir reāllaika izpildes posms, kas pārveido jaunu ievadi par modeļa izvadi.
Kāpēc inferencei ir nepieciešama skaitļošanas jauda
Mākslīgā intelekta inference nav vienkārša meklēšana datu bāzē. Liels modelis var saturēt miljardiem parametru, un tā izmantošanai ir nepieciešamas daudzas matemātiskas operācijas, lai informāciju pārvietotu caur modeli un aprēķinātu nākamo rezultātu.
Šis aprēķins bieži vien jāveic ātri. Čatbota atbilde, meklēšanas palīga reakcija vai tulkojums reāllaikā jāsaņem dažu sekunžu laikā vai pat ātrāk, tāpēc inference sistēmās liela nozīme tiek piešķirta latencei, atmiņas joslas platumam, partiju apstrādei, modeļa izmēram un aparatūras izmantošanai.
GPU un citi mākslīgā intelekta paātrinātāji ir noderīgi, jo tie spēj efektīvi veikt daudzas paralēlas operācijas. Jo lielāks ir modelis, jo garāks ir konteksts un jo vairāk ir vienlaicīgu lietotāju, jo rūpīgāk ir jāizstrādā inference infrastruktūra.
Inference piemēri ikdienas mākslīgajā intelektā
Kad čatbots atbild uz jautājumu, tas veic inferenci. Tas pats attiecas uz gadījumiem, kad attēlu ģenerators izveido attēlu pēc prompta, programmēšanas palīgs ierosina funkciju vai tulkošanas rīks pārvērš teikumu citā valodā.
Inference parādās arī mazāk pamanāmās sistēmās: ieteikumu plūsmā, kas rangē videoklipus, krāpšanas atklāšanas sistēmā, kas atzīmē aizdomīgu darījumu, medicīniskās attēlveidošanas modelī vai rūpnīcas redzes sistēmā, kas atklāj defektus.
Lietotājiem šie piemēri izskatās atšķirīgi, taču tiem ir viens un tas pats pamatprincips: apmācīts modelis saņem ievadi, veic aprēķinus un atgriež izvadi, kas kalpo par pamatu lēmumam, atbildei vai ģenerētam rezultātam.
Kāpēc inference ir svarīga enerģētikai un infrastruktūrai
Viens inference pieprasījums var būt neliels, taču mūsdienu mākslīgā intelekta sistēmas darbojas milzīgā mērogā. Miljoniem vai miljardiem promptu, attēlu pieprasījumu, ieteikumu un API izsaukumu var radīt nepārtrauktu slodzi GPU, tīkla, datu uzglabāšanas un dzesēšanas sistēmām.
Tāpēc secināšana ir centrālais elements mākslīgā intelekta infrastruktūrā. Apmācība varbūt ir visredzamākais aprēķinu process, taču secināšana atkārtojas katru reizi, kad cilvēki izmanto ieviestos mākslīgā intelekta rīkus. Globālā mērogā šī atkārtotā izmantošana var kļūt par galveno faktoru, kas veicina pieprasījumu pēc GPU un datu centru elektroenerģijas patēriņu.
Viena AI vaicājuma precīzās enerģijas izmaksas ir atkarīgas no modeļa lieluma, aparatūras, partiju apstrādes, izmantošanas pakāpes, datu centra efektivitātes un izvades veida. Svarīgi ir tas, ka inference saista ikdienas AI lietošanu ar fizisko infrastruktūru: mikroshēmām, serveriem, elektroenerģiju, dzesēšanu un datu centriem.
Kā tiek optimizēta secināšana
Mākslīgā intelekta pakalpojumu sniedzēji velta ievērojamus inženiertehniskos resursus, lai padarītu inferenci ātrāku, lētāku un efektīvāku. Pakotēšana ļauj vienlaikus apstrādāt vairākus pieprasījumus, kešēšana — atkārtoti izmantot jau paveikto darbu, bet maršrutēšana — nosūtīt vienkāršākus uzdevumus mazākiem vai specializētiem modeļiem.
Citas metodes samazina nepieciešamo aprēķinu apjomu. Kvantizācija ļauj attēlot modeļa vērtības kompakti, destilācija — pārnest darbības uz mazāku modeli, savukārt atzarošana vai arhitektūras izmaiņas — novērst nevajadzīgo darbu, vienlaikus saglabājot nepieciešamo kvalitāti.
Svarīga nozīme ir arī specializētajai aparatūrai. GPU, mākslīgā intelekta paātrinātāji, ātrs tīkls un atmiņa ar lielu joslas platumu palīdz ieviestajiem modeļiem uzticami darboties lielā mērogā. Labāka inference efektivitāte var samazināt aizturi, izmaksas un elektroenerģijas patēriņu, taču tā nepadara infrastruktūru nevajadzīgu.