Obsah
Inference nastává, když se používá model umělé inteligence
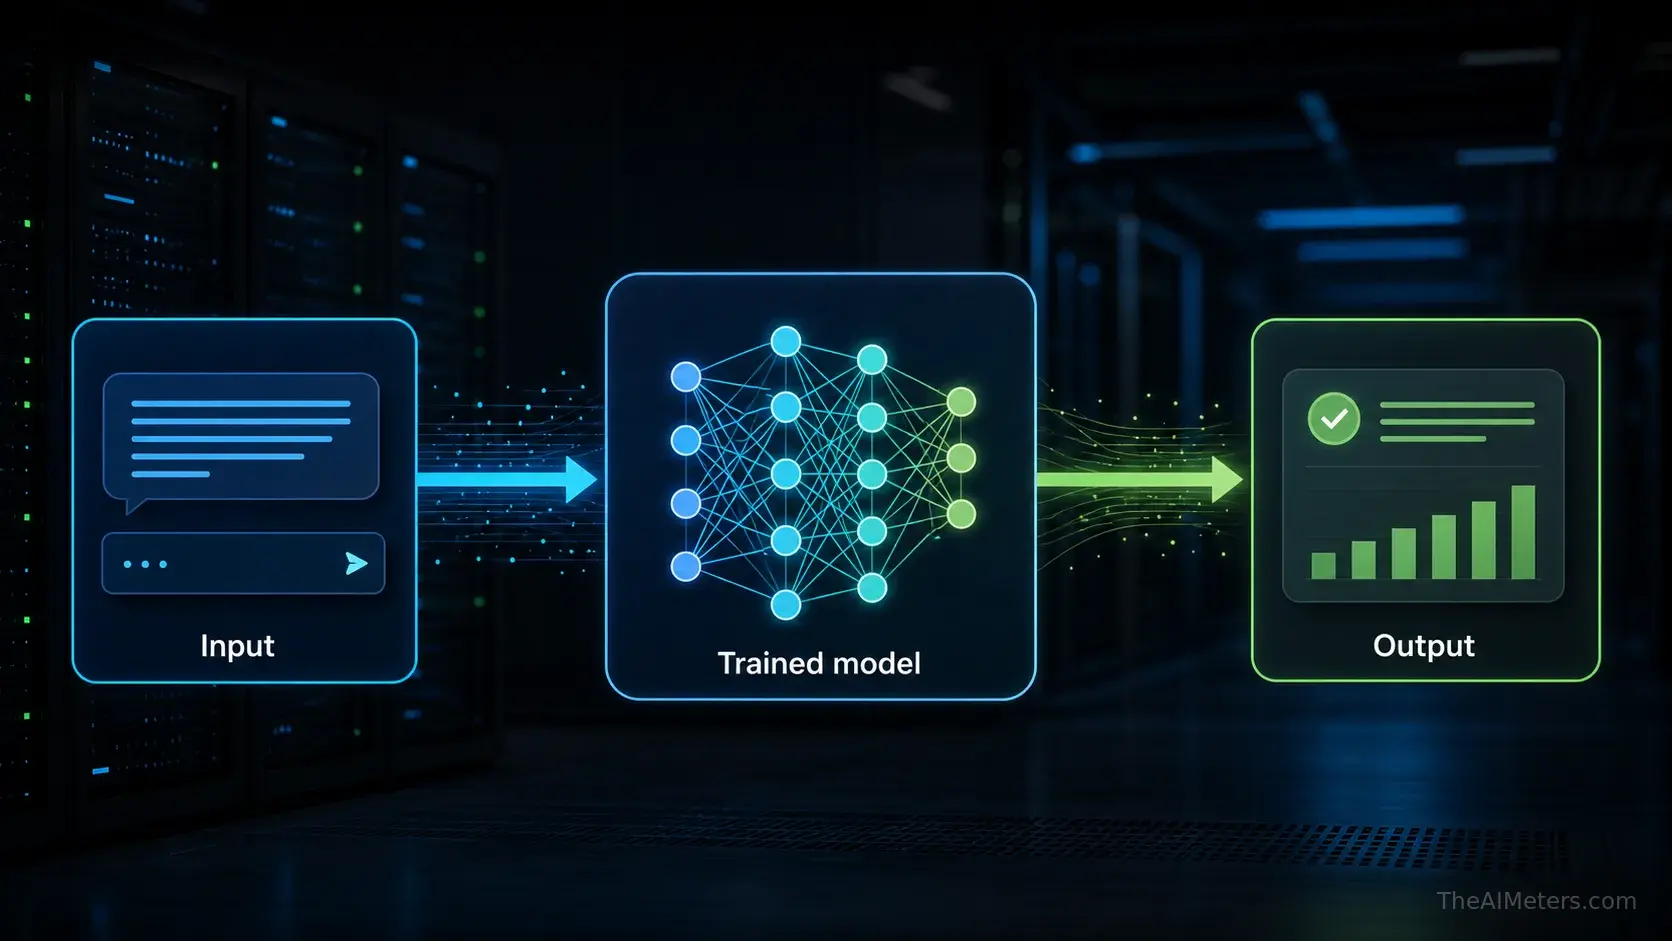
Inference umělé inteligence probíhá poté, co byl model již vycvičen. Uživatel, aplikace nebo automatizovaný systém odešle nový vstup a vycvičený model využije to, co se naučil během tréninku, k vytvoření užitečného výstupu.
Tímto vstupem může být písemný pokyn, vyhledávací dotaz, obrázek produktu, hlasový záznam, řádek kódu nebo řádek v databázi. Výstupem může být odpověď, vygenerovaný obrázek, klasifikace, doporučení, překlad nebo předpověď.
Právě proto každá odpověď ChatGPT, generování obrázků pomocí umělé inteligence, výsledek vyhledávacího asistenta, doporučovací systém i rozhodnutí v rámci moderace obsahu zahrnuje inferenci. Model se pokaždé znovu nevytváří. Spouští se pouze na nových datech.
Trénování model vytváří, inference jej spouští
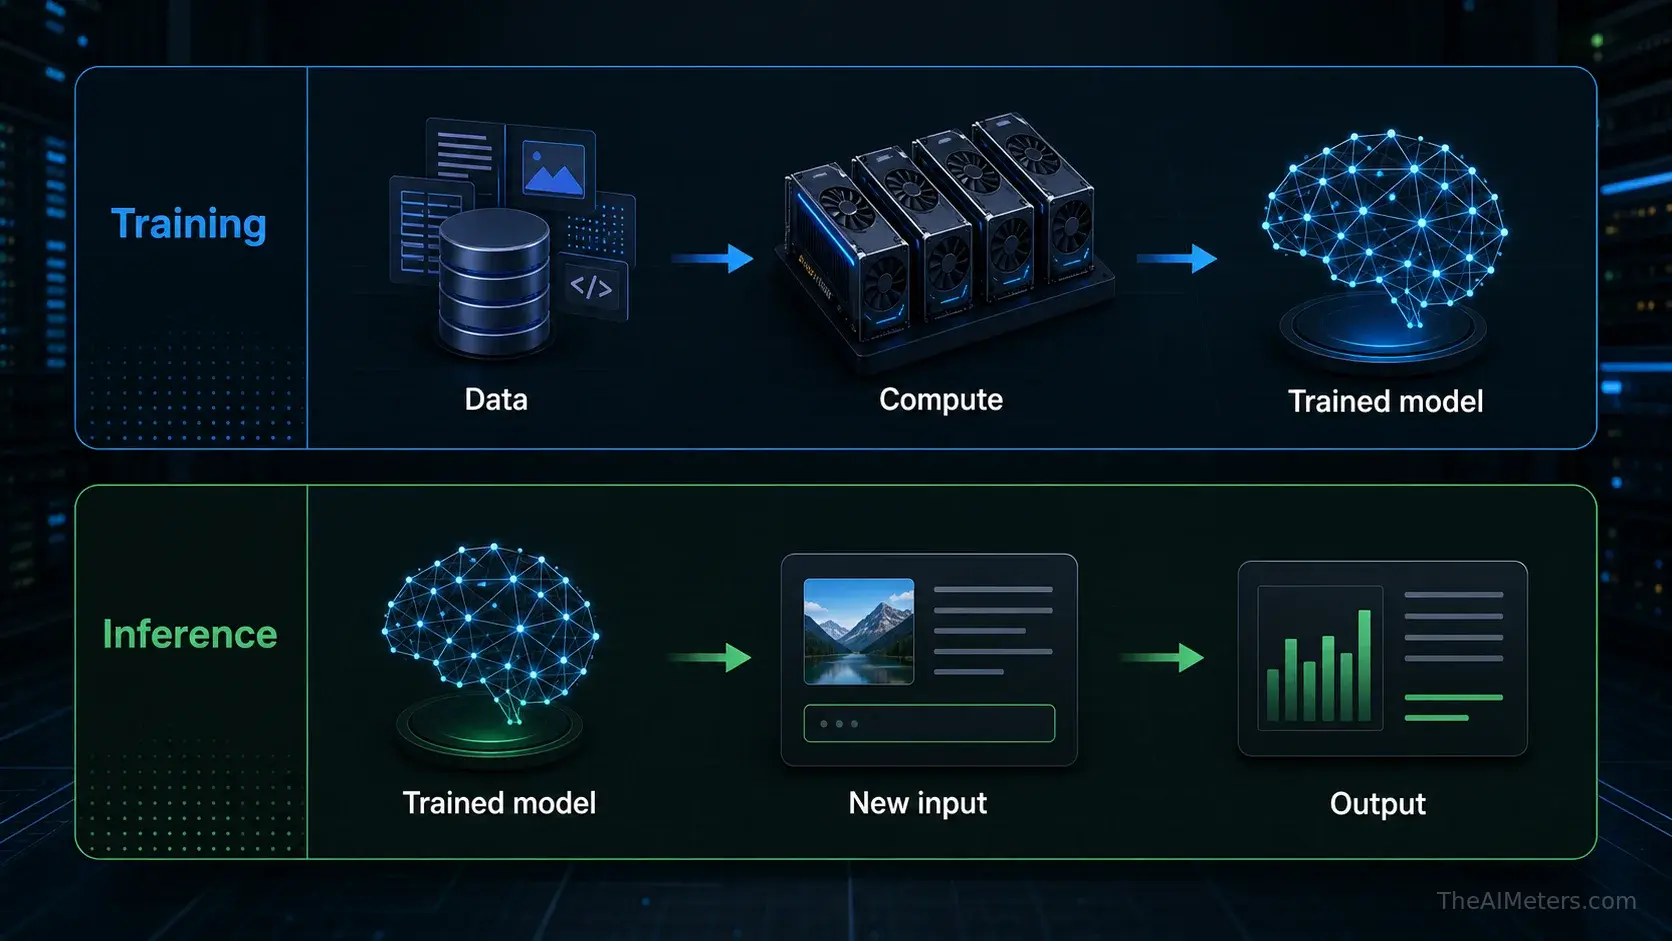
Trénování a inferenční výpočet jsou dvě odlišné fáze téhož systému umělé inteligence. Trénování vytváří nebo aktualizuje model tím, že zpracovává rozsáhlé datové soubory, porovnává předpovědi s příklady a v mnoha opakovaných krocích upravuje vnitřní parametry.
Inference začíná až poté, co tento tréninkový proces vygeneruje použitelný model. Trénovaný model se nasadí na servery, přijímá nové vstupy a aplikuje naučené vzorce, aniž by musel znovu procházet celým tréninkovým procesem.
Rozdíl si lze snadno zapamatovat takto: trénink představuje způsob, jakým se model učí, zatímco inferenční výpočet představuje způsob, jakým se model používá. Podrobnější vysvětlení první fáze najdete v průvodci o tom, jak se trénují modely umělé inteligence.
Co se děje během inferenčního procesu umělé inteligence?
Přesné kroky závisí na typu modelu, ale základní postup je podobný. Do systému dorazí vstupní data, systém je připraví ve formátu, který model očekává, model provede výpočty s použitím svých parametrů a systém převede výstup modelu do podoby, kterou může uživatel přečíst, zobrazit nebo použít.
U jazykového modelu se zadání obvykle rozdělí na tokeny. Model tyto tokeny vyhodnotí a krok za krokem předpovídá pravděpodobné následující tokeny. U obrazového modelu může být vstupem text, obrázek nebo obojí, a model postupně generuje pixely nebo vizuální charakteristiky, které odpovídají zadání.
Jiné systémy mohou klasifikovat dokument, řadit výsledky vyhledávání, rozpoznávat objekty na obrázku, přepisovat řeč nebo doporučovat produkty. V každém z těchto případů je inferenční proces krokem v reálném čase, který transformuje nový vstup na výstup modelu.
Proč inference vyžaduje výpočetní výkon
Inference umělé inteligence není pouhým vyhledáváním v databázi. Rozsáhlý model může obsahovat miliardy parametrů a jeho použití vyžaduje mnoho matematických operací, které zajišťují tok informací modelem a výpočet dalšího výstupu.
Tento výpočet musí být často proveden rychle. Odpověď chatbota, reakce vyhledávacího asistenta nebo překlad v reálném čase by měly být k dispozici během několika sekund či ještě rychleji, a proto se u inferenčních systémů klade důraz na latenci, šířku pásma paměti, dávkové zpracování, velikost modelu a využití hardwaru.
Grafické procesory (GPU) a další akcelerátory umělé inteligence jsou užitečné, protože dokážou efektivně provádět mnoho paralelních operací. Čím větší je model, čím delší je kontext a čím více je současně připojených uživatelů, tím pečlivěji je třeba navrhnout infrastrukturu pro inferenci.
Příklady inference v každodenní umělé inteligenci
Když chatbot odpoví na otázku, provádí inferenci. Totéž platí i v případě, kdy generátor obrázků vytvoří obrázek na základě promptu, asistent pro programování navrhne funkci nebo překladatelský nástroj převede větu do jiného jazyka.
Inference se objevuje i v méně viditelných systémech. Ať už jde o feed s doporučeními, který řadí videa podle relevance, systém detekce podvodů, který označuje podezřelé transakce, model pro lékařské zobrazování, který zvýrazňuje oblast zájmu, nebo systém průmyslového vidění detekující vady – všechny tyto systémy využívají vycvičené modely na nových datech.
Tyto příklady se uživatelům jeví odlišně, ale mají společný základní vzorec: vycvičený model přijme vstup, provede výpočet a vrátí výstup, který slouží jako podklad pro rozhodnutí, odpověď nebo vygenerovaný výsledek.
Proč je inferenční analýza důležitá pro energetiku a infrastrukturu
Jedna žádost o odvození může být malá, ale moderní systémy umělé inteligence pracují v obrovském měřítku. Miliony či miliardy zadání, požadavků na obrázky, doporučení a volání API mohou vytvářet nepřetržitou zátěž pro grafické procesory, síťová zařízení, úložiště i chladicí systémy.
Právě proto je inferenční zpracování klíčovou součástí infrastruktury umělé inteligence. Trénování je sice nejviditelnější výpočetní operací, ale inferenční zpracování se opakuje pokaždé, když lidé používají nasazené nástroje umělé inteligence. V globálním měřítku se toto opakované používání může stát hlavním faktorem ovlivňujícím poptávku po grafických procesorech (GPU) a spotřebu elektřiny v datových centrech.
Přesné energetické náklady na jeden dotaz v rámci umělé inteligence závisí na velikosti modelu, hardwaru, způsobu dávkování, vytížení, účinnosti datového centra a typu výstupu. Důležité je, že inferenční proces propojuje každodenní využívání umělé inteligence s fyzickou infrastrukturou: čipy, servery, napájení, chlazení a datová centra.
Jak se optimalizuje odvozování
Poskytovatelé umělé inteligence vynakládají značné technické úsilí na to, aby byl proces odvozování výsledků rychlejší, levnější a efektivnější. Díky dávkovému zpracování lze zpracovávat více požadavků najednou, ukládání do mezipaměti umožňuje opětovné využití opakovaných úkonů a směrování umožňuje přesměrovat jednodušší úkoly na menší nebo specializované modely.
Jiné techniky snižují náročnost výpočtů. Kvantizace umožňuje kompaktnější reprezentaci hodnot modelu, destilace umožňuje přenést chování do menšího modelu a prořezávání či změny architektury mohou odstranit zbytečnou práci při zachování užitečné kvality.
Důležitý je také specializovaný hardware. Grafické procesory, akcelerátory umělé inteligence, rychlé síťové připojení a paměť s vysokou šířkou pásma pomáhají nasazeným modelům spolehlivě reagovat i ve velkém měřítku. Vyšší efektivita inferenčních výpočtů může snížit latenci, náklady i spotřebu elektřiny, ale infrastruktura tím nezmizí.