Cuprins
Se vorbește despre inferență atunci când se utilizează un model de IA
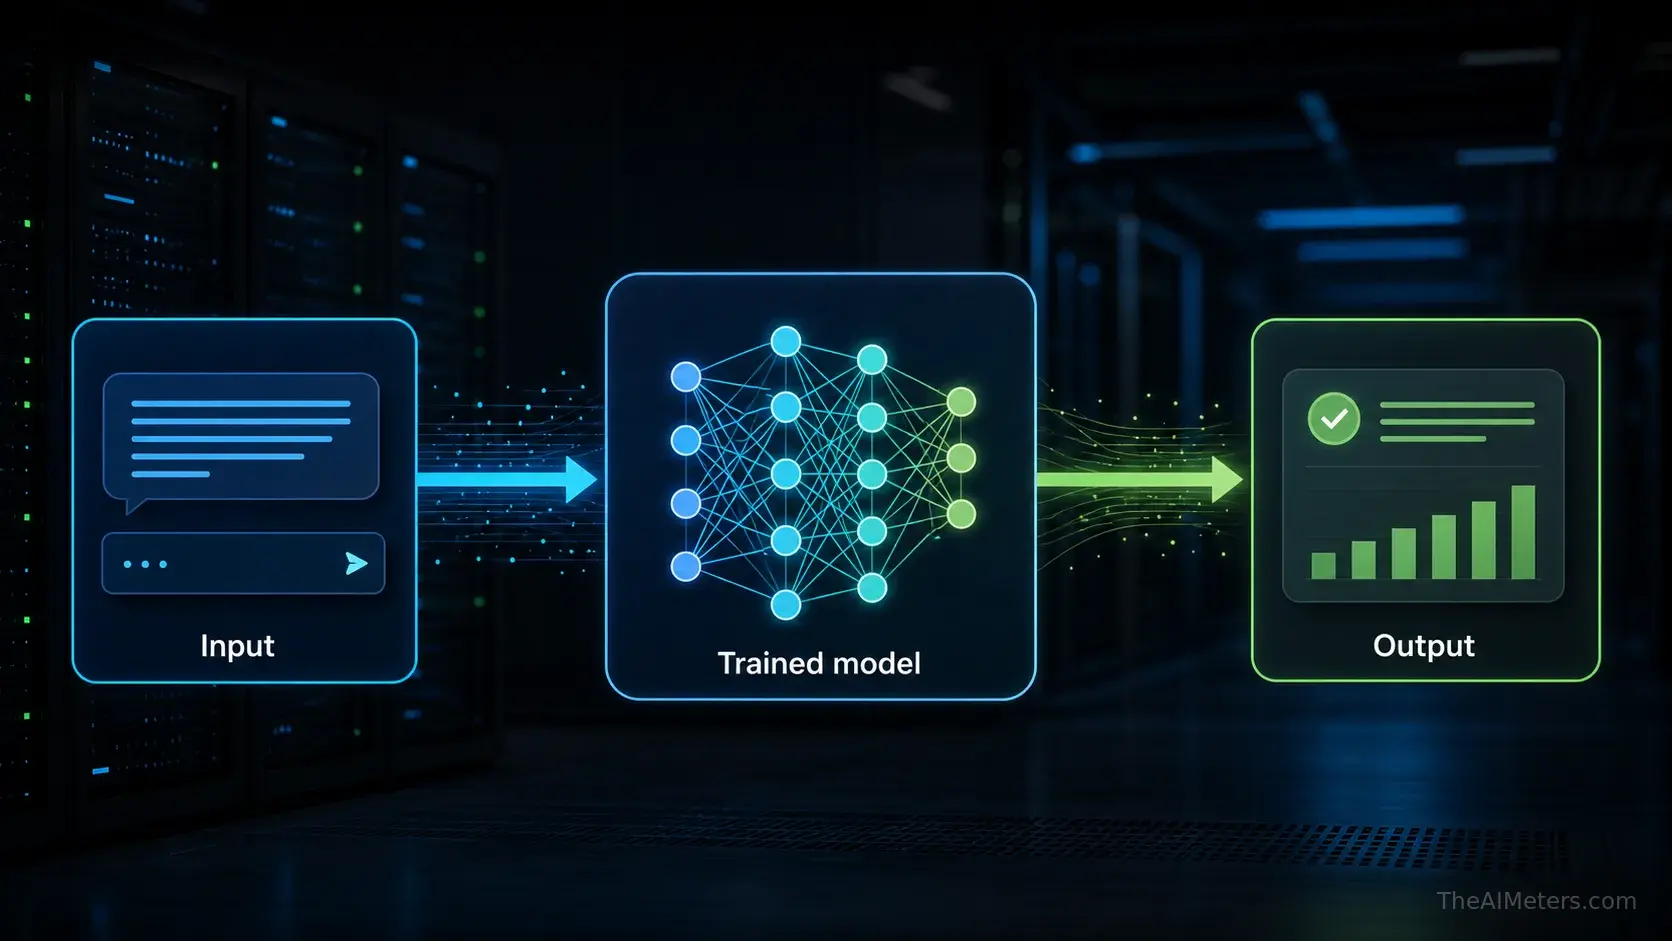
Inferența AI are loc după ce un model a fost deja antrenat. Un utilizator, o aplicație sau un sistem automatizat trimite o nouă intrare, iar modelul antrenat folosește ceea ce a învățat în timpul antrenamentului pentru a genera un rezultat util.
Această intrare poate fi o instrucțiune scrisă, o interogare de căutare, o imagine a unui produs, o înregistrare vocală, o linie de cod sau un rând dintr-o bază de date. Rezultatul poate fi un răspuns, o imagine generată, o clasificare, o recomandare, o traducere sau o predicție.
De aceea, fiecare răspuns al ChatGPT, fiecare generare de imagini prin IA, fiecare rezultat al asistentului de căutare, fiecare motor de recomandări și fiecare decizie de moderare a conținutului implică un proces de inferență. Modelul nu este reconstruit de fiecare dată, ci este rulat pe date noi.
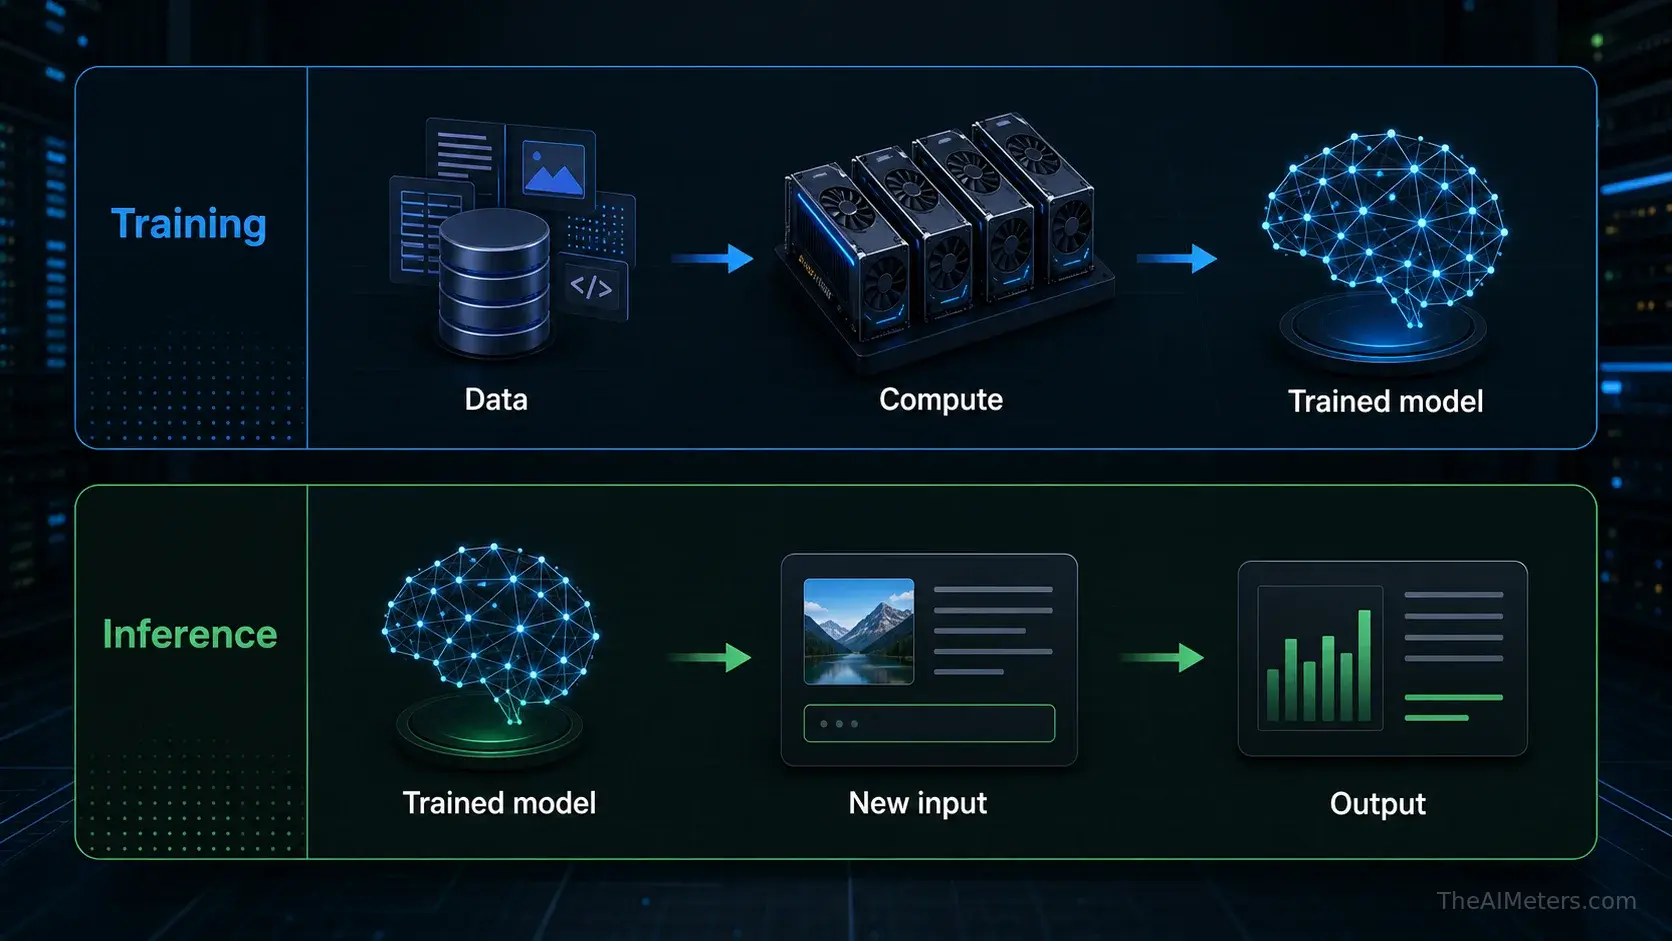
Antrenarea construiește modelul, iar inferența îl execută
Antrenarea și inferența sunt două etape distincte ale aceluiași sistem de inteligență artificială. Antrenarea creează sau actualizează modelul prin procesarea unor seturi de date de mari dimensiuni, compararea predicțiilor cu exemple concrete și ajustarea parametrilor interni pe parcursul multor etape repetate.
Inferența începe după ce procesul de antrenare a generat un model funcțional. Modelul antrenat este implementat pe servere, primește date de intrare noi și aplică tiparele învățate fără a mai parcurge din nou întregul proces de antrenare.
O modalitate simplă de a reține diferența este următoarea: antrenarea reprezintă modul în care modelul învață, în timp ce inferența reprezintă modul în care modelul este utilizat. Pentru o explicație mai detaliată a primei etape, consultați ghidul privind modul în care sunt antrenate modelele de IA.
Ce se întâmplă în timpul inferenței AI?
Pașii exacți depind de tipul modelului, dar procedura de bază este similară. Se primește o intrare, sistemul o pregătește în formatul așteptat de model, modelul efectuează calculele pe parametrii săi, iar sistemul transformă rezultatul modelului într-un format pe care utilizatorul îl poate citi, vizualiza sau utiliza.
În cazul unui model lingvistic, un prompt este de obicei împărțit în tokenuri. Modelul evaluează aceste tokenuri și prezice tokenurile următoare probabile, pas cu pas. În cazul unui model de imagine, datele de intrare pot fi text, o imagine sau ambele, iar modelul generează treptat pixeli sau caracteristici vizuale care corespund cererii.
Alte sisteme pot clasifica un document, ierarhiza rezultatele căutării, detecta obiecte într-o imagine, transcrie vorbirea sau recomanda un produs. În fiecare dintre aceste cazuri, inferența reprezintă etapa de execuție în timp real care transformă o nouă intrare într-o ieșire a modelului.
De ce inferența necesită putere de calcul
Inferența AI nu este o simplă căutare într-o bază de date. Un model de mari dimensiuni poate conține miliarde de parametri, iar utilizarea acestuia necesită numeroase operații matematice pentru a transmite informațiile prin model și a calcula următorul rezultat.
Acest calcul trebuie să se desfășoare adesea rapid. Un răspuns al unui chatbot, al unui asistent de căutare sau o traducere în timp real ar trebui să apară în câteva secunde sau chiar mai repede, așa că sistemele de inferență acordă o importanță deosebită latenței, lățimii de bandă a memoriei, procesării în loturi, dimensiunii modelului și gradului de utilizare a hardware-ului.
Procesoarele grafice (GPU) și alți acceleratori de IA sunt utili deoarece pot efectua numeroase operații paralele în mod eficient. Cu cât modelul este mai mare, cu cât contextul este mai extins și cu cât numărul de utilizatori simultani este mai mare, cu atât infrastructura de inferență trebuie proiectată cu mai multă atenție.
Exemple de inferență în domeniul IA din viața de zi cu zi
Atunci când un chatbot răspunde la o întrebare, acesta efectuează o inferență. Același lucru este valabil și atunci când un generator de imagini creează o imagine pe baza unei solicitări, un asistent de programare sugerează o funcție sau un instrument de traducere transformă o propoziție într-o altă limbă.
Inferența apare și în sisteme mai puțin vizibile. Un flux de recomandări care clasează videoclipurile, un sistem de detectare a fraudelor care semnalează o tranzacție, un model de imagistică medicală care evidențiază o zonă de interes sau un sistem de vizualizare industrială care detectează defecte – toate acestea utilizează modele antrenate pe date noi.
Aceste exemple par diferite pentru utilizatori, dar au același model de bază: un model antrenat primește o intrare, efectuează calcule și returnează o ieșire care stă la baza unei decizii, a unui răspuns sau a unui rezultat generat.
De ce inferența este importantă pentru sectorul energetic și cel al infrastructurii
O singură cerere de inferență poate fi de dimensiuni reduse, dar sistemele moderne de IA funcționează la scară uriașă. Milioane sau miliarde de solicitări de date, cereri de imagini, recomandări și apeluri API pot genera o cerere continuă asupra GPU-urilor, rețelelor, sistemelor de stocare și celor de răcire.
De aceea, inferența ocupă un rol central în infrastructura IA. Antrenarea poate fi procesul de calcul cel mai vizibil, dar inferența se repetă de fiecare dată când utilizatorii folosesc instrumentele de IA implementate. La scară globală, această utilizare repetată poate deveni un factor major al cererii de GPU-uri și al consumului de energie electrică al centrelor de date.
Costul energetic exact al unei interogări de IA depinde de dimensiunea modelului, de hardware, de gruparea datelor, de gradul de utilizare, de eficiența centrului de date și de tipul rezultatului. Aspectul important este că inferența leagă utilizarea zilnică a IA de infrastructura fizică: cipuri, servere, energie electrică, sisteme de răcire și centre de date.
Cum se optimizează inferența
Furnizorii de soluții de IA depun eforturi tehnice considerabile pentru a face procesul de inferență mai rapid, mai ieftin și mai eficient. Procesarea în loturi permite tratarea simultană a mai multor solicitări, stocarea în cache permite reutilizarea operațiunilor repetate, iar rutarea permite redirecționarea sarcinilor mai simple către modele mai mici sau specializate.
Alte tehnici reduc volumul de calcul necesar. Cuantificarea permite reprezentarea valorilor modelului într-un format mai compact, distilarea poate transfera comportamentul într-un model mai mic, iar eliminarea elementelor inutile sau modificările de arhitectură pot elimina operațiunile inutile, păstrând în același timp calitatea utilă.
Și hardware-ul specializat joacă un rol important. Plăcile grafice (GPU), acceleratoarele de IA, rețelele rapide și memoria cu lățime de bandă mare ajută modelele implementate să răspundă în mod fiabil la scară largă. O eficiență mai bună a inferenței poate reduce latența, costurile și consumul de energie electrică, dar nu face ca infrastructura să dispară.