Зміст
Інференція відбувається тоді, коли використовується модель ШІ
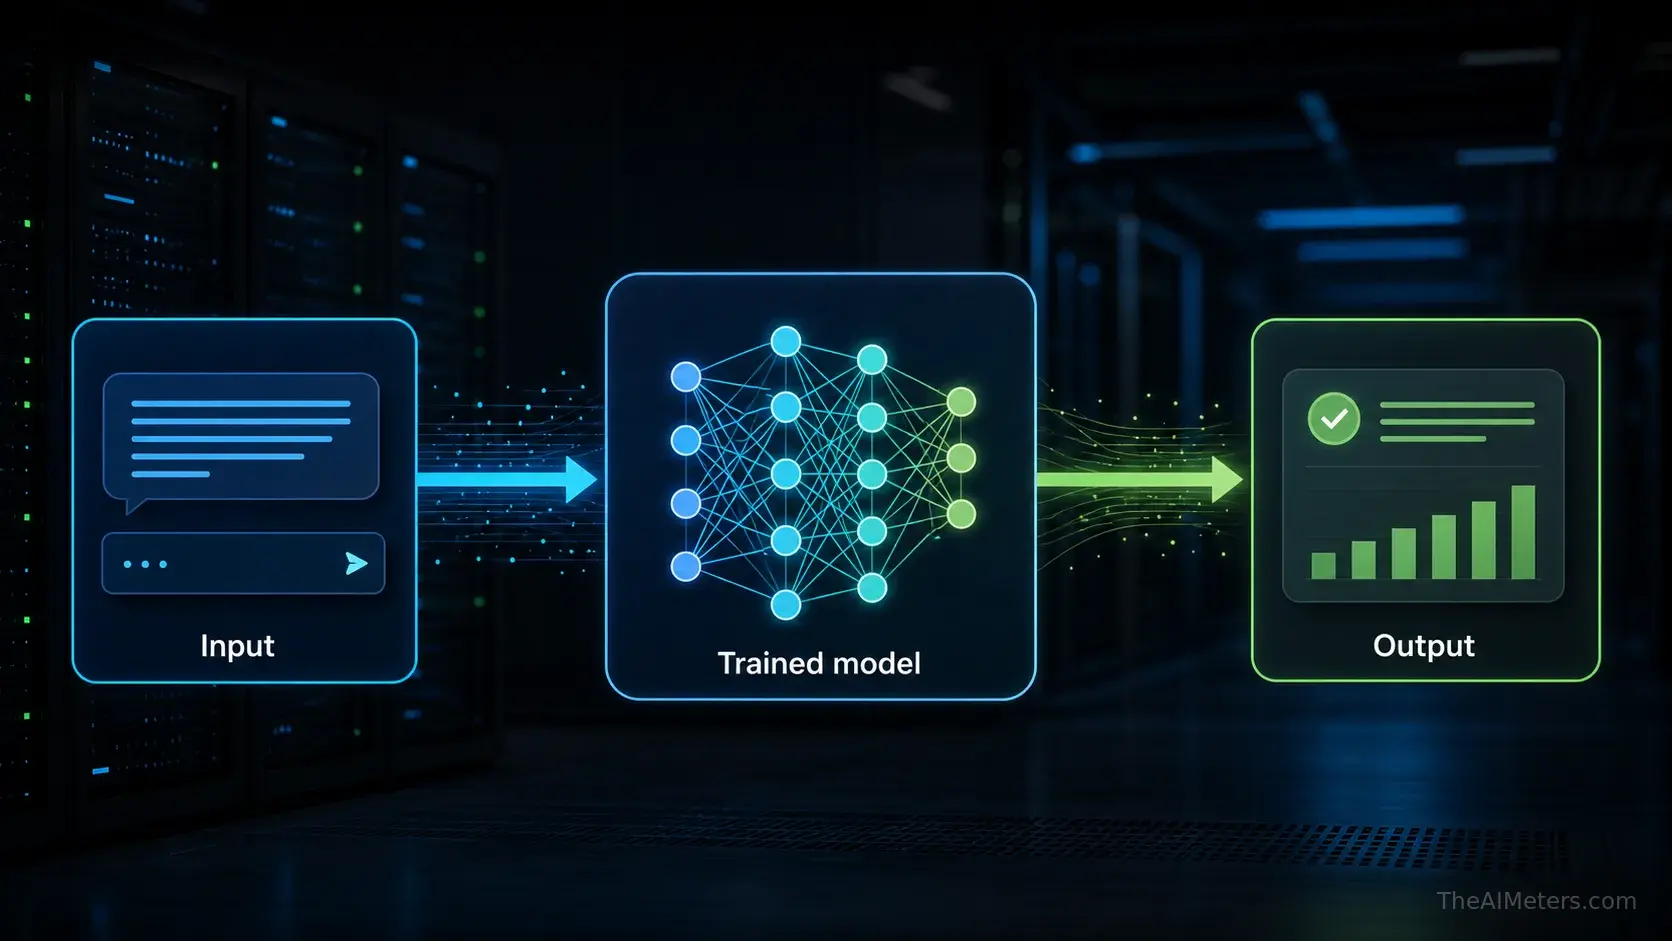
Обчислення на основі штучного інтелекту відбуваються після того, як модель вже була навчена. Користувач, додаток або автоматизована система надсилає нові вхідні дані, а навчена модель використовує знання, отримані під час навчання, для формування корисного результату.
Цим вхідним даними може бути письмове завдання, пошуковий запит, зображення товару, голосовий запис, рядок коду або рядок у базі даних. Вихідними даними можуть бути відповідь, згенероване зображення, класифікація, рекомендація, переклад або прогноз.
Саме тому кожна відповідь ChatGPT, генерація зображень за допомогою ШІ, результат роботи пошукового помічника, робота системи рекомендацій та рішення щодо модерації контенту передбачають процес виведення. Модель не перебудовується щоразу заново. Вона просто застосовується до нових даних.
Під час навчання будується модель, а під час інференції вона запускається
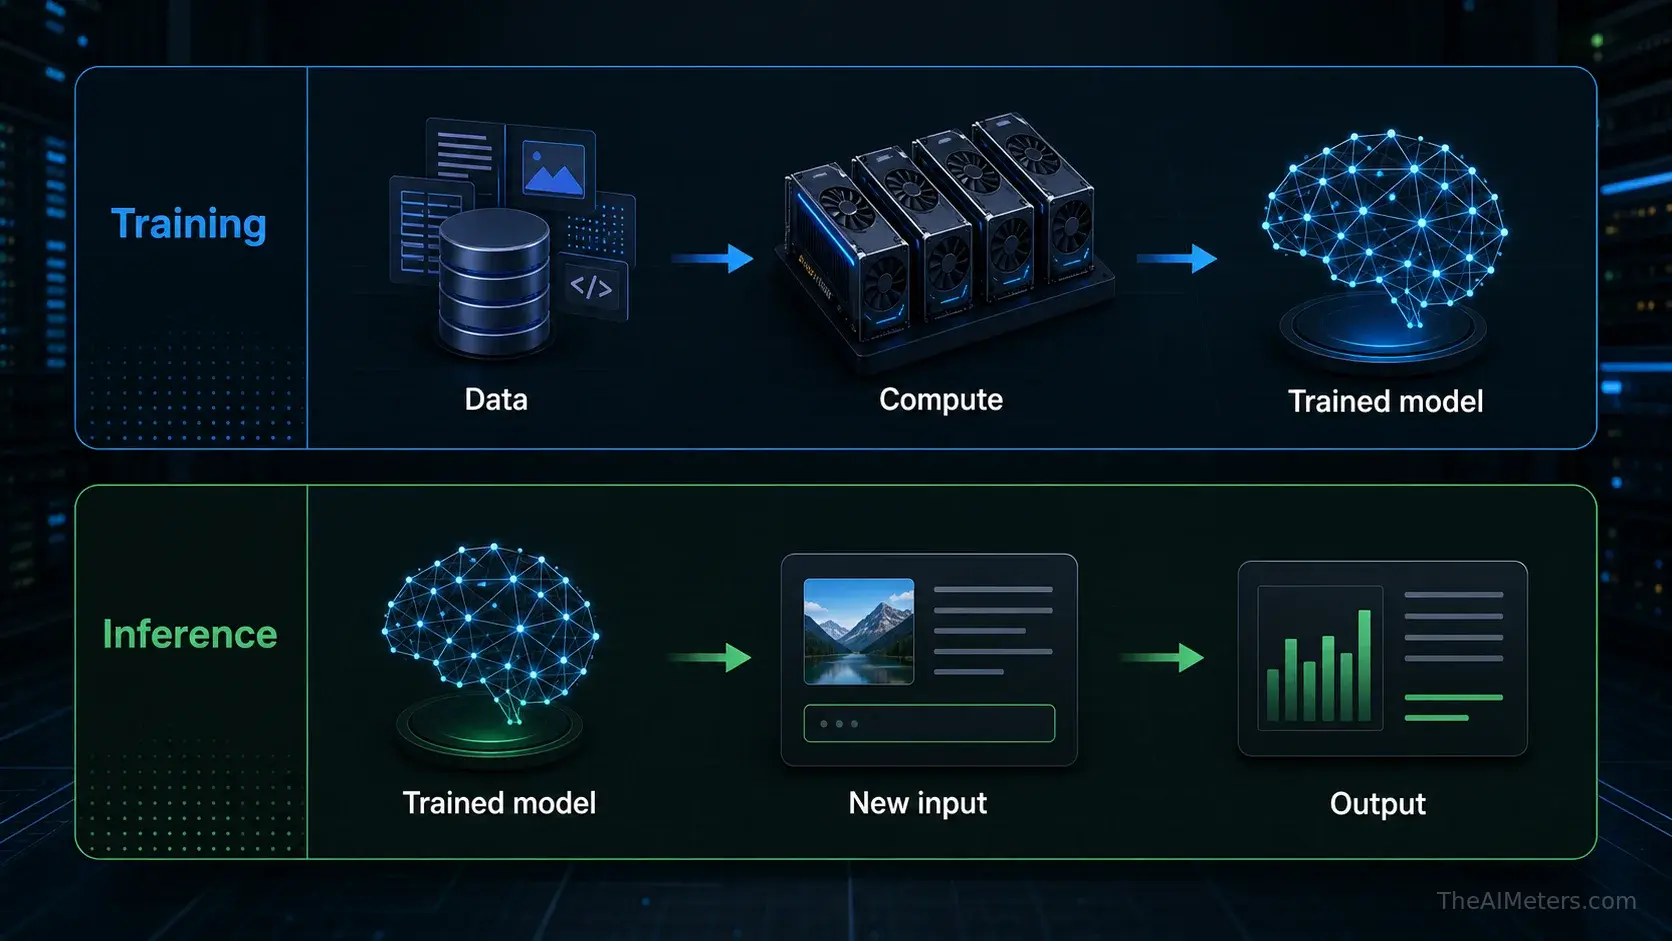
Навчання та інференція — це два різних етапи роботи однієї й тієї ж системи штучного інтелекту. Під час навчання модель створюється або оновлюється шляхом обробки великих наборів даних, порівняння прогнозів із прикладами та коригування внутрішніх параметрів у ході численних повторюваних кроків.
Виведення починається після того, як у результаті навчання було створено придатну для використання модель. Навчена модель розгортається на серверах, отримує нові вхідні дані та застосовує засвоєні закономірності, не проходячи повного процесу навчання знову.
Ось простий спосіб запам’ятати різницю: навчання — це процес, під час якого модель навчається, а інференція — це спосіб використання моделі. Більш детальне пояснення першого етапу дивіться в посібнику про те, як навчають моделі штучного інтелекту.
Що відбувається під час інференції ШІ?
Конкретні кроки залежать від типу моделі, але загальний алгоритм дій є схожим. Надходить вхідні дані, система готує їх у форматі, який очікує модель, модель виконує обчислення за своїми параметрами, а система перетворює вихідні дані моделі у формат, який користувач може прочитати, переглянути або використати.
У випадку мовної моделі запит зазвичай розбивається на токени. Модель аналізує ці токени та крок за кроком прогнозує ймовірні наступні токени. У випадку моделі обробки зображень вхідними даними можуть бути текст, зображення або й те, й інше, і модель поступово генерує пікселі або візуальні ознаки, що відповідають запиту.
Інші системи можуть класифікувати документ, ранжувати результати пошуку, розпізнавати об’єкти на зображенні, розпізнавати мовлення або рекомендувати товар. У кожному з цих випадків інференція — це етап виконання в режимі реального часу, який перетворює нові вхідні дані на вихідні дані моделі.
Чому інференція потребує обчислювальних ресурсів
Обчислення на основі штучного інтелекту — це не простий пошук у базі даних. Велика модель може містити мільярди параметрів, і для її використання потрібно виконати безліч математичних операцій, щоб передати інформацію через модель і обчислити наступний результат.
Ці обчислення часто мають виконуватися швидко. Відповідь чат-бота, реакція пошукового помічника або переклад у режимі реального часу повинні надходити за лічені секунди або навіть швидше, тому в системах інференції велике значення мають затримка, пропускна здатність пам’яті, об’єднання даних у пакети, розмір моделі та завантаження апаратного забезпечення.
Графічні процесори (GPU) та інші прискорювачі штучного інтелекту є корисними, оскільки вони здатні ефективно виконувати велику кількість паралельних операцій. Чим більша модель, чим довший контекст і чим більше одночасних користувачів, тим ретельніше потрібно проектувати інфраструктуру для інференції.
Приклади виведення у повсякденному застосуванні штучного інтелекту
Коли чат-бот відповідає на запитання, він виконує інференцію. Те саме відбувається, коли генератор зображень створює картинку на основі prompt, помічник з програмування пропонує функцію або інструмент перекладу перетворює речення іншою мовою.
Інференція застосовується також у менш помітних системах: стрічці рекомендацій, системі виявлення шахрайства, моделі медичної візуалізації або системі машинного зору на заводі.
Ці приклади виглядають по-різному для користувачів, але їх об’єднує одна й та сама основна схема: навчена модель отримує вхідні дані, виконує обчислення та повертає результат, який слугує основою для прийняття рішення, надання відповіді або формування результату.
Чому інференція має важливе значення для енергетики та інфраструктури
Один запит на інференцію може бути невеликим, але сучасні системи штучного інтелекту працюють у величезних масштабах. Мільйони чи мільярди запитів на обробку, запитів на зображення, рекомендацій та викликів API можуть створювати постійне навантаження на графічні процесори, мережеві системи, системи зберігання даних та системи охолодження.
Саме тому інференція відіграє ключову роль в інфраструктурі штучного інтелекту. Навчання, можливо, є найбільш помітним обчислювальним процесом, але інференція повторюється щоразу, коли люди використовують розгорнуті інструменти штучного інтелекту. У глобальному масштабі таке повторюване використання може стати одним із головних чинників, що визначають попит на графічні процесори та споживання електроенергії в центрах обробки даних.
Точні енерговитрати на один запит до системи штучного інтелекту залежать від розміру моделі, апаратного забезпечення, організації пакетів даних, ступеня завантаження, ефективності центру обробки даних та типу вихідних даних. Важливо те, що інференція пов’язує повсякденне використання штучного інтелекту з фізичною інфраструктурою: мікросхемами, серверами, електроенергією, системами охолодження та центрами обробки даних.
Як оптимізується процес виведення
Розробники штучного інтелекту докладають чимало технічних зусиль, щоб зробити інференцію швидшою, дешевшою та ефективнішою. Пакетна обробка дозволяє обробляти кілька запитів одночасно, кешування — повторно використовувати результати повторюваних операцій, а маршрутизація — направляти простіші завдання до менших або спеціалізованих моделей.
Інші методи дозволяють зменшити обсяг необхідних обчислень. Квантування дає змогу подавати значення моделі в більш компактному вигляді, дистиляція — переносити поведінку в меншу модель, а обрізка або зміни архітектури — усунути зайві обчислення, зберігаючи при цьому корисну якість.
Важливе значення має й спеціалізоване обладнання. Графічні процесори, прискорювачі штучного інтелекту, швидкі мережеві з’єднання та пам’ять з високою пропускною здатністю допомагають розгорнутим моделям надійно реагувати в умовах масштабного використання. Підвищення ефективності інференції дозволяє зменшити затримку, витрати та споживання електроенергії, але це не означає, що інфраструктура перестає бути необхідною.